RAG Ibrido per SAP ABAP/HCM con ChromaDB, Ollama e Qwen
Ingegnerizzazione di una pipeline di retrieval specializzata per repository SAP ABAP/HCM mission-critical. Integrazione bidirezionale tra ricerca semantica vettoriale, lexical scan per termini DDIC, content deduplication V4 e scoring strutturale proprietario.
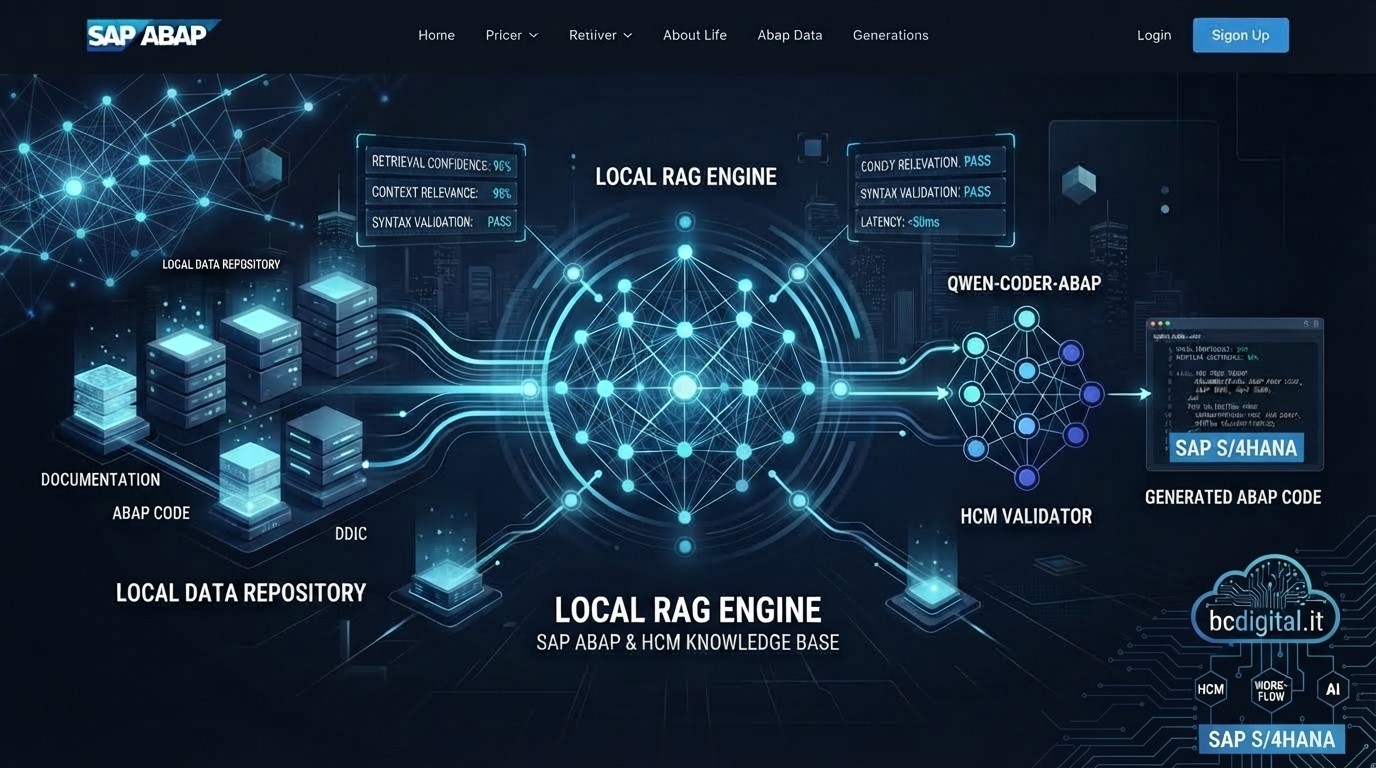

Perché i Vector Database Generici Falliscono nel Codice SAP
Nel dominio enterprise SAP, una query come PA0001 non rappresenta un vago concetto discorsivo ma un identificatore DDIC rigoroso e ad altissima criticità operativa.
Interrogazione Base ABAP
Accesso sistematico a decine di migliaia di include, classi OO, function modules HR e macro standard.
Recupero Codice Mirato
Isolamento di reali logiche di business ed estrazione dei blocchi sintattici attivi anziché frammenti sparsi.
Fusione Ibrida Bidirezionale
Accoppiamento sincronizzato tra similarità vettoriale profonda (cosine) e scansione lessicale esatta (Exact Match).
Riconoscimento DDIC
Mappatura automatica di tabelle infotype (PA0001, PA0002) e campi chiave (PERNR, KOSTL, WERKS, BEGDA).
Eliminazione Duplicati V4
Deduplicazione basata su hashing del contenuto sorgente per superare il limite dei soli metadati file.
Ranking Strutturale ABAP
Premiazione di costrutti SQL ed accessi diretti (SELECT SINGLE) rispetto a semplici dichiarazioni DATA.
Contesto Compatto Qwen
Compressione selettiva del payload per garantire il rispetto assoluto della context window di 4096 token.
Generazione Sintattica 7.40+
Generazione di codice ABAP pulito, aderente alle linee guida SAP moderne con variabili host inline @.
Ricerca di utilizzi effettivi e dipendenze strutturali
Durante il test isolato con la query "PA0001", una ricerca vettoriale classica restituiva 30 chunk parzialmente disallineati. La pipeline ibrida ha scansionato 46.346 chunk estraendo con precisione i pattern legati a PERNR, KOSTL, WERKS, PERSG, BEGDA ed ENDDA.
Dalla Query Utente al Codice ABAP Verificato
Il diagramma di runtime descrive il percorso rigoroso a step: analisi semantico-lessicale in parallelo, de-duplicazione profonda del codice, riordinamento sintattico e validazione dell'output.
Infrastruttura On-Premise a Zero Leakage Informativo
L'intero stack opera in ambiente isolato locale per rispettare la riservatezza totale del repository sorgente aziendale e la compliance con le direttive SAP Governance.
Parametri di Deployment Attivi
from pathlib import Path

from langchain_ollama import OllamaEmbeddings

from langchain_chroma import Chroma


# Parametri d'ambiente persistente locale

DB_DIR = Path(r"C:\Progetto_AI\Abap_VectorDB")

COLLECTION_NAME = "abap_hcm"

EMBEDDING_MODEL = "nomic-embed-text:latest"

OLLAMA_BASE_URL = "http://127.0.0.1:11434"


# Inizializzazione connettori

embeddings = OllamaEmbeddings(

    model=EMBEDDING_MODEL,

    base_url=OLLAMA_BASE_URL

)


vector_db = Chroma(

    collection_name=COLLECTION_NAME,

    embedding_function=embeddings,

    persist_directory=str(DB_DIR)

)Digital Twin & SAP ABAP Knowledge Graph
Trasformazione del patrimonio legacy SAP in un gemello digitale di conoscenza navigabile e pronto per gli agenti AI di nuova generazione.
Ingegnerizzazione Reale: I Problemi Risolti in Produzione
Dettaglio delle criticità computazionali riscontrate durante lo scaling sui 46.346 chunk e soluzioni algoritmiche adottate dalla V1 alla V5.1.
Il Fallimento della Sola Ricerca Semantica
La chiamata iniziale vector_db.similarity_search(k=30) produceva 30 risultati non focalizzati. Per identificatori categorici come PA0001, gli embedding catturano affinità concettuali ma ignorano la presenza fisica dell'infotype.
ChromaDB "Too Many SQL Variables"
La query lessicale massiva mandava in crash SQLite: code 1: too many SQL variables. Impossibile interrogare tutti i record in una singola transazione.
Normalizzazione e Separazione Table/Field
Evitare che identificatori come PERNR vengano scambiati per sottostringhe arbitrarie. Risolto inoltre il bug per cui PA0001 veniva classificato simultaneamente come tabella e come campo.
Content Deduplication V4: Oltre i Metadati
I file esportati spesso presentano nomi diversi ma blocchi sorgente identici (es. ztm_simulazione_ele.txt vs ..._ele_1.txt). La sola deduplicazione per metadata creava gravissimo bias e spreco di token.
SAP Structural Ranking: Riconoscere l'Accesso Reale
Nel codice ABAP, una dichiarazione dati deve valere infinitamente meno di una query di estrazione. La formula proprietaria valuta la sintassi attiva:
Context Window Crunch: 4489 vs 4096 Token
Qwen restituiva eccezione fatale: request (4489 tokens) exceeds the available context size (4096 tokens). La qualità del retrieval non equivale alla gestione del contesto di generazione.
Linee Guida per Sistemi RAG su Codice Enterprise
Principi cardine applicabili a qualsiasi stack mission-critical (SAP, Oracle, COBOL, mainframe) dove l'allucinazione di un identificatore comporta blocchi di produzione.
Separare Retrieval e Ranking
Il layer di retrieval raccoglie tutti i candidati potenziali; il layer di ranking stabilisce l'autorevolezza sintattica. Mai usare il primo score vettoriale come verdetto.
Il Codice ha Struttura Sintattica
Nel software la presenza di una stringa non ne certifica la funzione. È obbligatorio riconoscere clausole primarie: SELECT SINGLE, WHERE, LOOP AT, CALL FUNCTION.
Deduplicare Prima del Prompt
I duplicati consumano token, creano bias cognitivo nel modello e degradano i tempi di risposta. L'hashing di contenuto a monte è una conditio sine qua non.
Checklist di Conformità a 10 Controlli Rigorosi
Il codice generato da Qwen viene sottoposto a parsing deterministico. Se anche un singolo vincolo fallisce, la risposta viene rigettata prima di raggiungere il developer.
" Query profilata: Intent = data_read

" Tabella: PA0001 | Campi: KOSTL | Chiave: PERNR


SELECT SINGLE kostl

  FROM pa0001

  INTO @DATA(lv_kostl)

  WHERE pernr = @lv_pernr

    AND begda <= @sy-datum

    AND endda >= @sy-datum.


IF sy-subrc = 0.

  " Esecuzione logica certificata

ENDIF.
Uso di variabili host @, target declaration inline e restrizione temporale automatica BEGDA/ENDDA.
Metriche di Pipeline Registrate
Architettura Pronta per il Core S/4HANA Enterprise
Il motore ibrido estende la propria governance a Core Data Services (CDS), AMDP, BAdI enhancement framework e API OData v4 con la medesima precisione deterministica.
RAG Specializzato: La Risposta Ingegneristica all'Allucinazione nei Sistemi Core
La transizione da un generico "Query → Embedding → LLM" a una pipeline a doppio binario certificata dimostra che l'AI per l'Enterprise richiede comprensione profonda della semantica applicativa. Il sistema è pronto per essere scalato su repository FI-CO, SD, MM e logiche di migrazione ECC → S/4HANA.